这次更新,值得比较什么
选模型时,最有用的问题是:它能否把你的任务做完,完成一次要花多少钱,以及你现有的工具能否用好它。
Claude Opus 5.5 于 2026 年 9 月 22 日发布。同一天,OpenAI 发布 GPT‑6 Sol 和 GPT‑6 Luna;GPT‑6 Astra 则已在 9 月 3 日发布。本文按 9 月 23 日可查的官方资料整理价格、评测和接入方法。Anthropic 发布说明 · OpenAI 更新日志。
这次比较也纳入 Fable 5.1 和上一代 Opus 5,分别观察高价位 Claude 模型与同系列升级的差异。能力表保留官方五款模型的完整结果,其中 GPT‑5.6 Sol 与新发布的 GPT‑6 Sol 分开标明;价格部分另列新 GPT‑6 Sol/Luna。本文是官方资料解读,尚未进行 Onevium 内的独立模型横评。
先看价格:统一到标准 API 费率
以下均为 美元/百万 token,采用标准处理费率。GPT‑6 列按输入不超过 272K token 的请求计算;不包含工具调用、地区处理附加费,也不是 Claude 或 ChatGPT 的订阅价格。
| 模型 | 未缓存输入 | 缓存读取 | 输出 |
|---|---|---|---|
| Claude Opus 5.5 | $4 | $0.20 | $20 |
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| GPT‑6 Astra | $10 | $1.00 | $50 |
| GPT‑6 Sol | $2 | $0.20 | $10 |
| GPT‑6 Luna | $0.10 | $0.01 | $0.50 |
来源:Claude 模型规格、OpenAI API 价格。缓存写入与缓存读取是不同计费项;批处理、快速模式和特殊地区另按对应规则计算。
Opus 5 的输入/输出单价为 $5/$25,Opus 5.5 的 $4/$20 对应 20% 的单价降幅。缓存读取由 $0.50 降至 $0.20,降幅为 60%。Claude 更新说明。实际任务费用还取决于读取了多少材料、生成了多少计费 token,以及是否需要反复尝试。
这张表适合用来估预算。它不能单独回答哪款模型最划算:一个便宜但需要多次重做的结果,可能比一次通过验收的结果更贵。
Fable 5.1 的输入/输出价格与 Astra 相同,但缓存读取为 $0.25,不能把两者当成相同账单。相对 Fable,Opus 5.5 的输入与输出单价低 60%,缓存读取低 20%;长期重复使用上下文的任务,要分别统计这些计费项。Fable 5.1 官方价格。
能力对比:按任务读分数
Fable 5.1 是这次比较的重要参照:它能回答“Opus 5.5 是否已经接近更高价位的 Claude 模型”;Opus 5 则用来观察同系列升级。下面保留官方的 五款模型、九项评测,同时比较编程、知识工作、推理、电脑操作与图表识别。
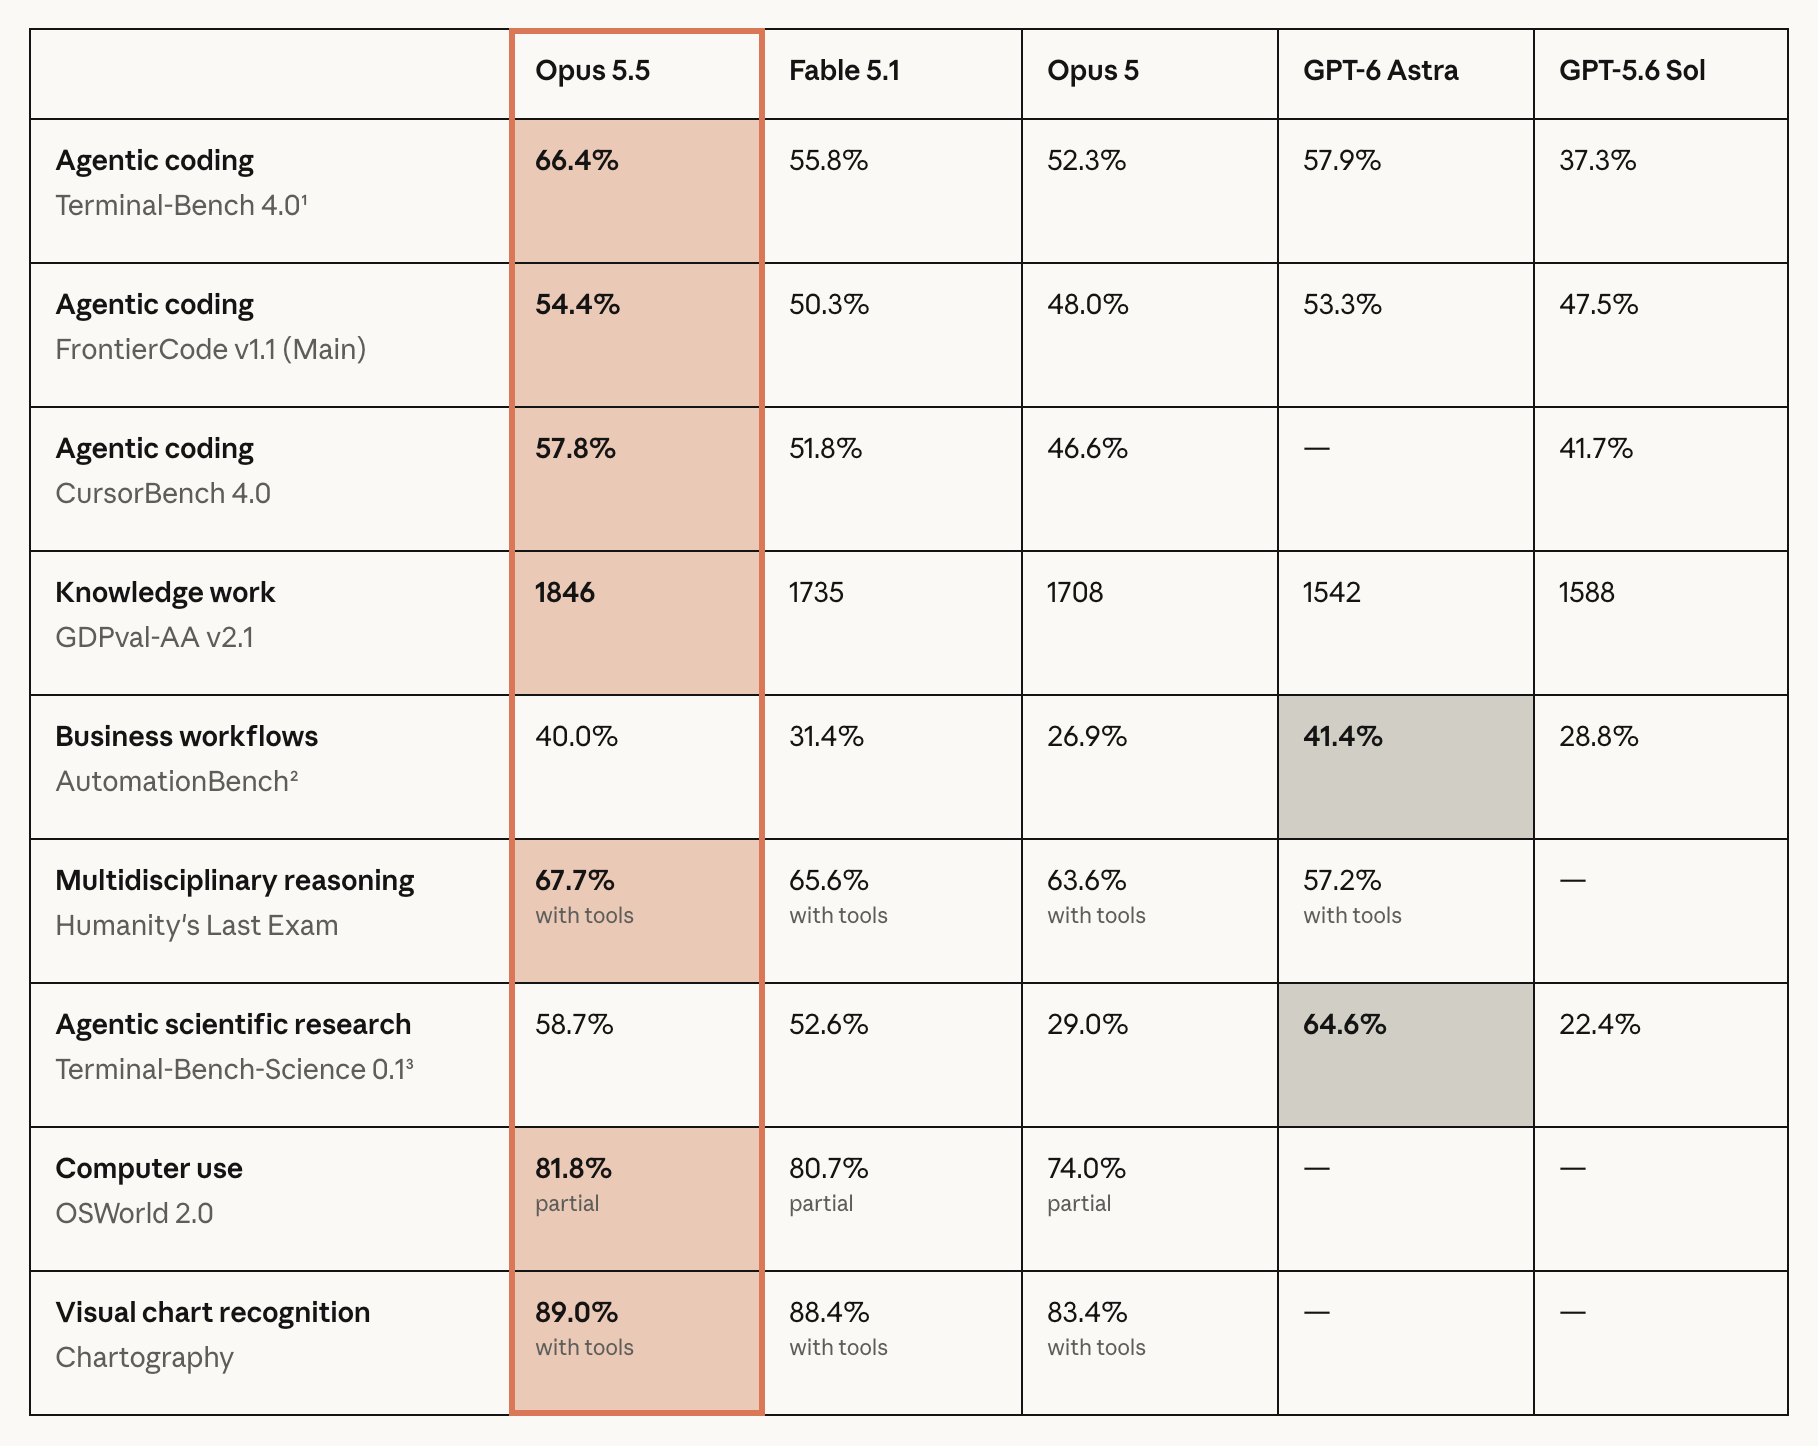
来源:Anthropic 官方发布页。保留原图及其模型名称;点击图片可查看原图。下表提供可复制的文字版,手机上可横向滚动。
| 评测 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT‑6 Astra | GPT‑5.6 Sol |
|---|---|---|---|---|---|
| Terminal‑Bench 4.0 · 终端编程 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 Main · 代码修改 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 · 多文件编程 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| GDPval‑AA v2.1 · 知识工作(Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench · 业务工作流 | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam · 使用工具 | 67.7% | 65.6% | 63.6% | 57.2% | — |
| Terminal‑Bench‑Science 0.1 · 科研任务 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0 · 电脑操作(partial) | 81.8% | 80.7% | 74.0% | — | — |
| Chartography · 图表识别,使用工具 | 89.0% | 88.4% | 83.4% | — | — |
这张表可以从三个方向看:
- 编程:分别看终端、多文件修改和可合并的代码改动,不把一个编程榜单当成全部开发能力。这里 Opus 5.5 在三项编程成绩上均高于 Fable 5.1 和 Opus 5。
- 知识工作:GDPval 使用 Elo 分数,不是百分比,也不能与其他行求平均。它更适合为文档、表格等工作选择试用候选;下面的成本曲线能进一步说明取舍。
- 任务差异:Astra 在 AutomationBench 和科研项中的分数较高。电脑操作和图表识别的 GPT 列为空,表示这张表未提供结果,不能按零分理解;OSWorld 的 partial、HLE 与 Chartography 的工具条件也应保留。
评测条件同样重要:除另有说明,Opus 5.5 使用 max;Terminal‑Bench 使用 Opus xhigh、Astra high。部分 Claude 测试在安全机制触发后回退到其他模型;AutomationBench 来自 Zapier,未使用回退。Terminal‑Bench 的 Opus 5.5 标准误为 ±2.6 个百分点,科研项各模型约 ±3.5–5 个百分点。分数接近时,不宜只按小数点排出确定胜负。完整评测脚注。
知识工作:把能力和任务成本放在一起看
同样叫“更强”,可能是花更多钱取得更高分,也可能是在接近的成本下交付更好的结果。GDPval‑AA v2.1 的曲线把这两个问题放在一起,尤其适合比较 Opus 5.5、Fable 5.1 和 Astra。
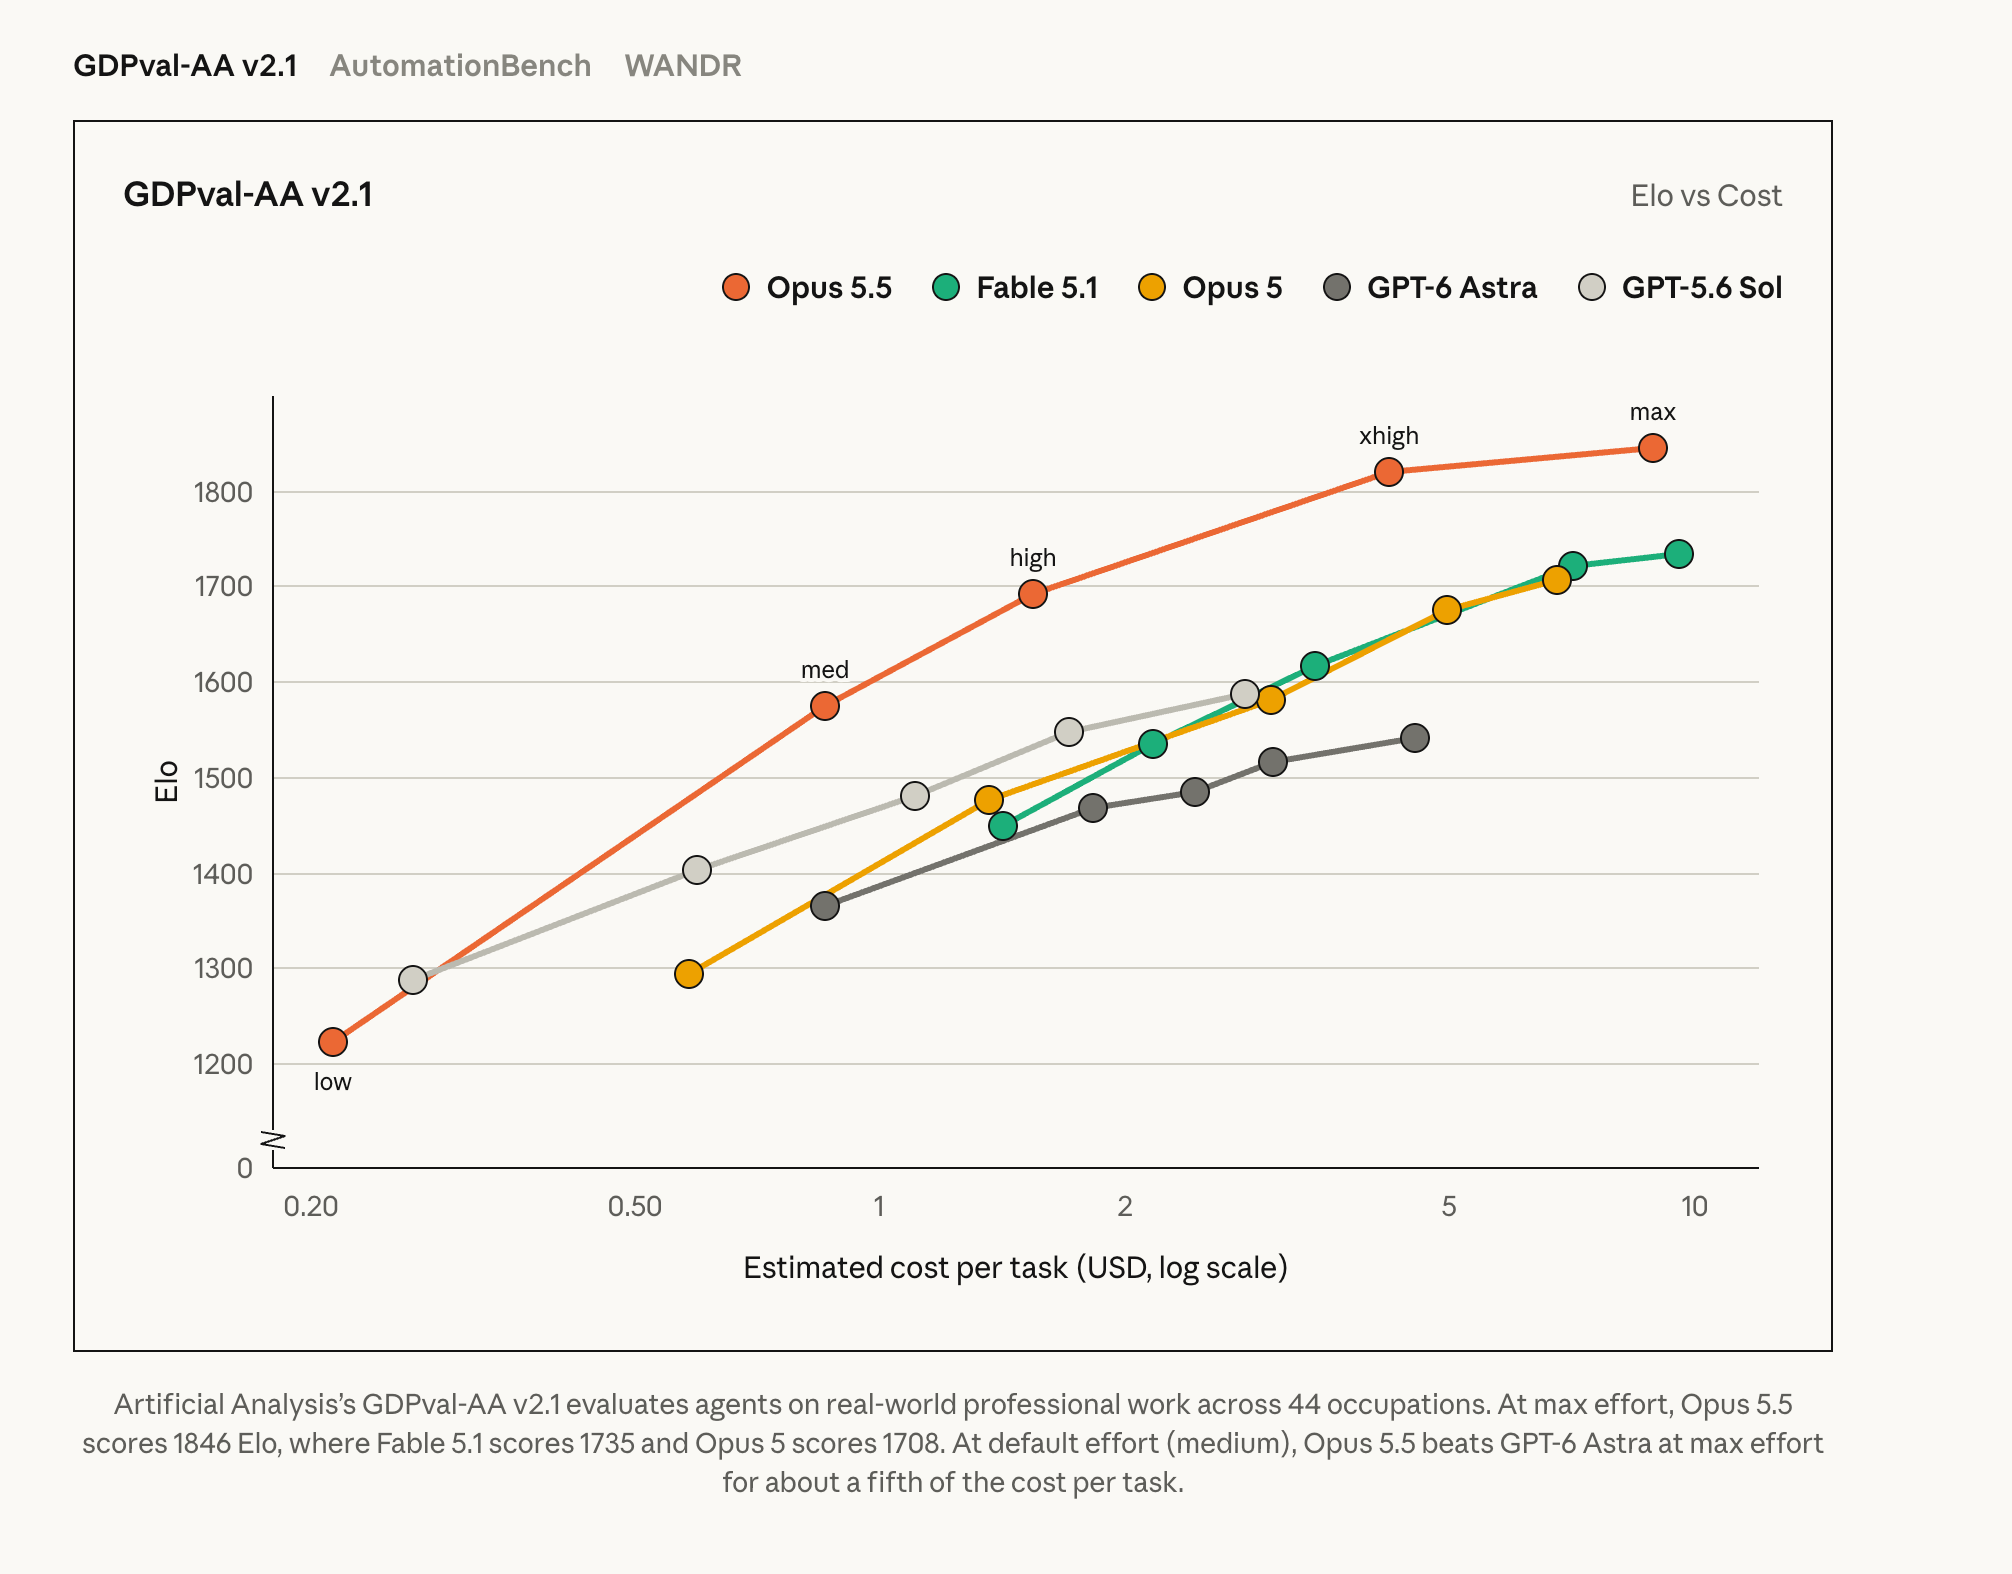
来源:Anthropic 知识工作评测,所用基准为 Artificial Analysis 的 GDPval‑AA v2.1,覆盖 44 类职业。图片保留官方图例、坐标和说明;点击可查看原图。
读图时关注这三件事:
- 横轴是每个任务的估算费用,不是每百万 token 单价。它使用对数刻度,相同的横向距离代表相同的倍数变化,而不是相同的美元差额。
- 纵轴是 Elo,越高越好。图上零点与主体区间之间有断轴;不能把两条曲线的视觉高度直接解释成能力提升百分比。对于接近的分数,更靠左的点意味着估算成本较低。
- 每款模型是一组工作档位,不是一个固定点。Opus 5.5 从 low 到 max 展示了分数和费用如何一起变化。试用模型时,应把推理力度也记录下来。
图中最高档位的 Opus 5.5 为 1846 Elo,Fable 5.1 为 1735,Opus 5 为 1708。官方同时指出,Opus 5.5 在默认 medium 档位已超过 Astra 的 max 档位,单任务估算成本约为其五分之一。这是该项评测及其配置下的结论,不应推成所有业务都能节省 80%。
对实际选型,我建议先比较各模型的默认档位,再为未通过验收的任务提高力度。这样能区分“模型不适合”和“当前档位投入不足”,也避免一开始就让每个简单任务都用最高档位。
算一次任务的费用,而不只看单价
用一个可复算的例子说明价格差异:假设请求使用 100,000 个未缓存输入 token 和 10,000 个计费输出 token,没有缓存写入、工具费用或额外附加费。
| 模型 | 计算 | token 费用 |
|---|---|---|
| Opus 5.5 | 0.1 × $4 + 0.01 × $20 | $0.60 |
| Fable 5.1 | 0.1 × $10 + 0.01 × $50 | $1.50 |
| Opus 5 | 0.1 × $5 + 0.01 × $25 | $0.75 |
| GPT‑6 Astra | 0.1 × $10 + 0.01 × $50 | $1.50 |
| GPT‑6 Sol | 0.1 × $2 + 0.01 × $10 | $0.30 |
| GPT‑6 Luna | 0.1 × $0.10 + 0.01 × $0.50 | $0.015 |
这是依据前表费率计算的统一用量示例,不是这些模型完成同一任务的实测账单。计费输出应包含供方收费的推理 token,不能只统计屏幕上看到的回答文字。
如果要为团队选择默认模型,可以拿三个已经知道正确结果的小任务试跑:一个代码修复、一个资料核对、一个结构化整理。给每个模型相同输入与验收要求,记录模型 ID、推理档位、工具权限、耗时、费用以及人工返工。
先判断结果能否交付,再比较每个合格结果的成本。具体记录方法可参考如何核对 AI 工作流的实际价值。
1M 上下文的容量与成本
Opus 5.5 和 Fable 5.1 的官方上下文窗口为 1M token;GPT‑6 Astra、Sol、Luna 的文档列出 1.05M。窗口要容纳输入、对话、工具返回和生成内容,不能把整个数字当成一次可上传的正文额度。Claude 规格 · Astra 规格 · Sol 规格 · Luna 规格。
更大的窗口适合需要同时保留多份材料的任务,但不会自动解决资料过期、相互矛盾或引用遗漏。先让模型定位相关文件,按任务补充必要材料,仍然比无差别塞入整个项目更容易核验。
GPT‑6 的输入超过 272K token 后,整个请求的输入和缓存费率为短上下文的 2 倍,输出费率为 1.5 倍。以 Astra 的 300,000 个未缓存输入 token、10,000 个计费输出 token 为例,费用为 0.3 × $20 + 0.01 × $75 = $6.75,仍不含工具等额外费用。长上下文价格规则。
还有一个实际使用区别:模型支持 1M,不代表客户端会话已经按 1M 运行。在 Onevium 中,接入服务商之后,还需要核对会话使用的模型条目与窗口。
在 Onevium 接入 Claude 与 GPT
Onevium 支持 Claude Code 登录、Anthropic API 和 OpenAI Responses 接入,可以在同一个桌面工作区中管理项目,并在不同会话中选择服务商和模型。先按服务商与模型文档连接,再用自己的小任务判断哪种组合更适合。
Opus 5.5、GPT‑6 Sol/Luna 的新预设与适配随 Onevium 1.2.2 提供,1.2.2 计划于 2026 年 9 月 23 日发布。请在正式版本发布后更新到 1.2.2 或更高版本,再按下面的步骤连接服务商、选择这些新型号。
接入方式如下:
- 有 Claude Code 账户时,在 Claude Code 连接状态面板进入登录,并在内置终端完成授权。
- 使用 API Key 时,打开 设置 → 服务商 → 添加 AI 服务,选择 Anthropic 或聊天服务中的 OpenAI。GPT 工具任务优先使用 OpenAI 预设的 Responses 连接。
- 填入该服务自己的 API Key 并保存。Onevium 许可证、Claude 订阅与 API 使用额度是不同事项。
- 回到聊天,新建会话,在输入框的模型菜单选择对应服务商和账户可用的模型。已支持的型号未显示时,在 管理模型中检查启用状态;自定义字段见模型条目与角色映射。
- 先发一条短消息验证连接,再让模型只读一个测试文件并概括内容。保存配置或“检查配置”成功,不代表上游请求和工具调用都已验证。
在 Onevium 开启并确认 1M 上下文
以已有接入文档覆盖的 GPT‑6 Astra 为例,先确认短消息能够正常回复,再打开 设置 → 服务商 → 对应连接 → 管理模型 → 添加自定义模型,展开该行的 高级字段:
| 字段 | 填写值 |
|---|---|
| 模型 ID | gpt-6-astra[1m] |
| 上游模型标识 | gpt-6-astra |
| 显示名 | GPT-6 Astra (1M) |
勾选启用并保存,新建会话后选中 GPT-6 Astra (1M),发送 /context,确认总量显示 1m,再发一句短消息确认连接仍正常。仅修改用量条对应的窗口数值,不能替代这个模型条目配置。
本地模型 ID 带 [1m],上游模型标识保持干净:不要把后缀也填进上游字段,更不要给实际不支持 1M 的模型添加它。上述验证确认的是会话配置与短请求连通,不代表已经完成百万 token 的压力测试。
Claude 连接的处理方式不同。对于需要显式开启的旧版 Claude 模型,入口是 设置 → Claude CLI → 1M 上下文窗口;自定义 Anthropic 兼容端点还需要在确认服务支持后开启 高级选项 → 接口支持 1M 上下文。原生 1M 模型应按所用版本的识别结果核对,不要直接照搬 GPT 的上游字段配置。
完整的连接类型差异、角色与子会话限制,以及 200k 未变为 1m 的排查步骤,见1M 上下文窗口指南。先完成模型接入,再确认窗口,最后用一个有明确验收标准的真实任务开始比较。